时间:2025-04-27 23:18
人气:
作者:admin
90年代,随着互联网初期发展,单机数据库架构(APP → Middleware → MySQL)完全够用,压力小,易于维护。
随着业务量增加,单机无法满足需求,出现了垂直拆分(不同模块用不同数据库)与读写分离(主库写,从库读)策略。
进一步为了减轻MySQL压力,开始在应用层引入文件缓存机制。
后续逐渐普及Memcached作为分布式缓存,大大提高了系统性能。
业务不断膨胀,最终演变为:
APP → Middleware → 缓存层(Memcached) → 多个MySQL集群(集群1、集群2、集群3)
水平拆分(分库分表)+ 多实例集群成为标配。
早期 MySQL 采用MyISAM引擎(表锁,效率低,事务支持差)。
后来转向InnoDB引擎(行级锁,支持事务、崩溃恢复、外键约束)。
随着移动互联网、社交应用爆发,MySQL遇到瓶颈。
引入NoSQL体系,存储如用户画像、地理位置、社交关系等数据,减轻关系型数据库压力。
NoSQL,全称 Not Only SQL,即“不仅仅是SQL”。
特点:
格式灵活:基于 Key-Value 或文档,数据类型多样。
无需固定表结构:方便迭代开发,支持敏捷开发和极限编程。
高扩展性和高性能:适应海量数据场景。
【扩展:敏捷开发】强调的是快速迭代、小步快跑、持续反馈、持续优化,而不是像传统开发那样一开始就写一大堆文档、一次性做完。项目分成很多小周期(通常2-4周叫做一个Sprint),每个周期都交付一个可以运行的版本。强调人与人的沟通(团队交流比写文档更重要)。
举个例子:
比如开发一个电商网站:
第一个Sprint:只做出首页+商品列表的最小功能;
第二个Sprint:增加商品详情页+简单下单功能;
第三个Sprint:接入支付;
中间每两周就交付一个小版本,客户可以体验,随时调整方向,比如改UI、换支付方式。
这样比起传统一次性做完一整年开发,灵活得多,也风险小得多!
【扩展:极限编程】简称 XP,是敏捷开发的一种具体实践方法。
| 对比点 | 关系型数据库(RDBMS) | NoSQL |
|---|---|---|
| 数据结构 | 结构化(表) | 灵活(键值、文档、列存、图) |
| 查询语言 | SQL | 多样(API调用、类SQL) |
| 数据一致性 | 强一致性 | 最终一致性(CAP理论) |
| 事务支持 | 支持ACID事务 | 弱化事务以换取扩展性 |
| 典型应用 | 金融、传统企业 | 社交、内容分发、日志存储 |
企业典型组合:MySQL + Redis
商品基本信息、评论(结构化文档) → MongoDB
商品图片(大文件存储) → FastDFS、OSS
搜索关键词、商品检索 → ElasticSearch
热门商品、秒杀活动缓存 → Redis、Tair、Memcached
交易、支付系统 → 仍以关系型数据库为主(如MySQL)
| 类型 | 代表产品 | 说明 |
|---|---|---|
| 键值(K-V)存储 | Redis、Tair、Memcached | 快速访问,缓存场景最佳 |
| 文档型数据库 | MongoDB | 类似JSON存储,灵活结构 |
| 列式数据库 | HBase、Cassandra | 适合大规模写入和分析 |
| 图数据库 | Neo4j | 适合存储复杂网络关系(社交、推荐系统) |
全称:Remote Dictionary Server(远程字典服务)
特点:
基于内存存储,极致高效
支持持久化
丰富的数据结构
用作缓存、数据库、消息中间件
支持发布订阅、地理位置分析、计时器、计数器等应用
Windows环境:下载 redis-cli.exe、redis-server.exe、redis-benchmark.exe 等。
Linux环境:
sudo apt-get install redis-server systemctl start redis redis-cli -p 6379
测试性能:
redis-benchmark -h localhost -p 6379 -c 100 -n 10000
(测试100个并发连接,每个连接发送10000次请求)
默认端口:6379
测试连接:
ping → pong
默认16个逻辑数据库(编号0~15)
常用命令:
select 0 # 切换数据库 DBSIZE # 查看当前数据库中Key数量 flushdb # 清空当前数据库 flushall # 清空所有数据库
Redis采用单线程事件循环处理请求,避免多线程锁竞争,效率极高。
性能瓶颈往往在于内存带宽和网络带宽,不是CPU!
主要存储在内存(RAM),访问速度极快。
持久化方式(可选):
RDB快照:周期性生成内存数据快照到磁盘。
AOF日志:记录每一次写操作,支持按日志重放恢复。
数据结构组织方式:
RedisDB └── dict哈希表 ├── key1 → value1 ├── key2 → value2 └── ...
配置 maxmemory 限制最大内存占用。
超出后可按策略淘汰数据:
LRU(最近最少使用)
LFU(最少访问次数)
TTL(按过期时间)
| 误区 | 正确理解 |
|---|---|
| 多线程一定比单线程快 | 错!多线程有锁竞争、上下文切换开销 |
| Redis单线程性能不足 | 错!Redis单线程可支撑几十万QPS,瓶颈一般是带宽和内存 |
最基础、最常用的数据类型,类似单纯的Key-Value存储。
基本操作
set name "hh" get name
过期时间设置
expire name 10 # 设置10秒后过期 ttl name # 查看剩余生存时间
type name
字符串追加
append name "haha" strlen name
set views 0 # 初始浏览量设为0
incr views # 自增1
decr views # 自减1
INCRBY views 10 # 设置步长为10
getrange key1 0 3 # 截取0-3下标的字符串
getrange key1 0 -1
setrange key2 1 xx # 将下标为1后面插入xx
setex key3 30 "hello" # 设置过期时间,30秒过期
setnx mykey "redis" # 当前值不存在再设置(在分布式锁常试用)若存在值则返回0(创建失败);不存在则创建返回1
mset k1 v1 k2 v2 k3 v3
mget k1 k2 k3
msetnx k1 v1 k4 v4 # k1存在,k4成功,但最后还是返回0(是一个原子性操作)
set user:1 {name: zhangsan, age :3} # 设置一个user:1对象 值为json字符串来保存对象
mset user:1:name zhangsan user:1:age 2
mget user:1:name user:1:age
getset db redis # 若不存在值,则返回nil
get db # redis
getset db mongodb # 若存在值,获取原来的值,redis
get db # mongodb
String是redis中最基础、最常用的数据类型。本质上是二进制安全的字节序列(byte array)。可以存:文本字符串、整数、二进制数据(如一张图片的二进制流)。
| 内容特点 | 底层结构 | 特点 |
| 小的简单字符串(短文本) | SDS(简单动态字符串) | 内存连续、长度可变 |
| 能表示为整数 | 直接以整数编码 | 省内存,操作更快 |
【SDS是什么:Simple Dynamic String】redis自定义的一种字符串结构,比C语言的裸char数组更安全、更高效。
struct SDS {
    int len;     // 实际使用的长度
    int alloc;   // 分配的总容量
    char buf[];  // 字符数组
}
- 记录长度(O(1)取长度,不用遍历)
- 预分配空间(减少频繁扩容)
- 二进制安全(允许存、0)
- 自动扩容&缩容    --->简单来说,SDS是高性能、可变长、带长度标记的字符串,比传统C字符串安全得多。
【整数优化(int编码)】如果你存的是一个纯整数,比如SET key 10086,redis底层并不会用SDS,而是直接把值存成int64类型,编码方式设置为int编码。好处是:内存更小(只有8字节),运算更快(比如INCR直接整数加法,不需要字符串转数字)
在redis里面,可以把list当成栈、队列、阻塞队列。list的操作还是push和pop比较多。
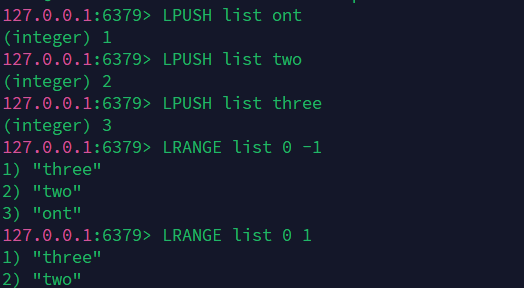
往尾部添加元素
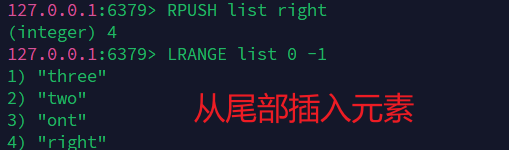

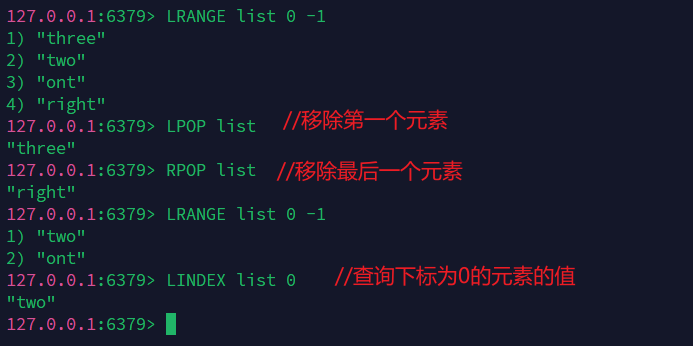
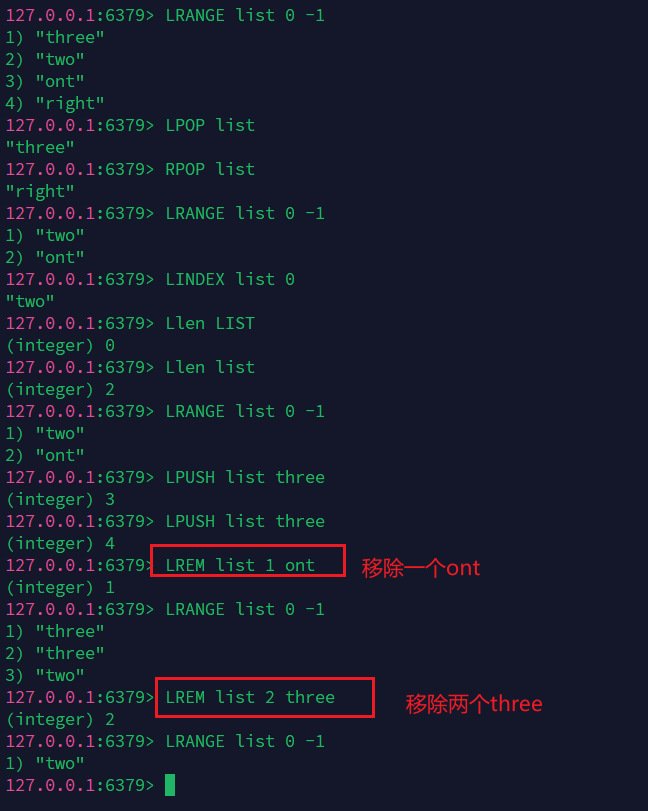
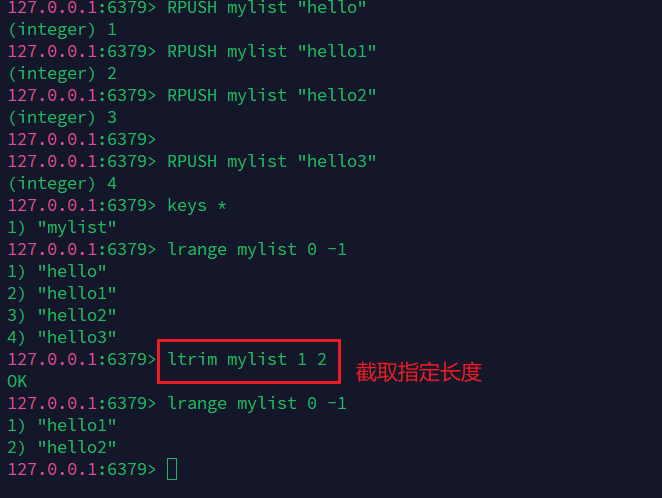
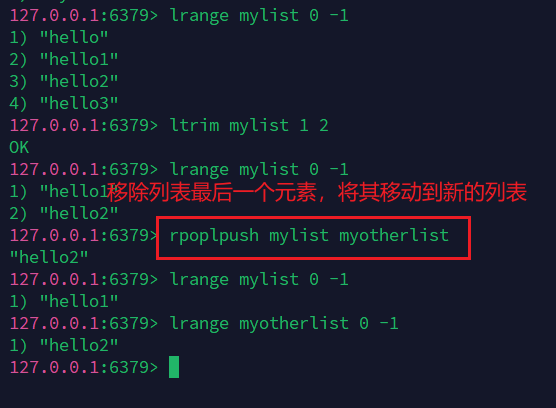
rpoplpush:组合命令,从一个列表的尾部取出元素,加入到另一个列表的头部
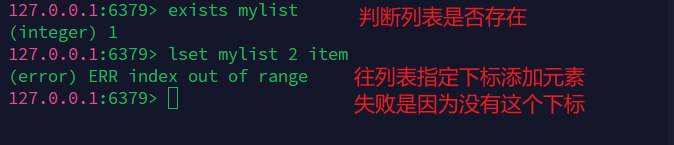
lset:存在则相当于更新,不存在则报错。
linsert:将某个具体的值插入到列表具体的值前面/后面。
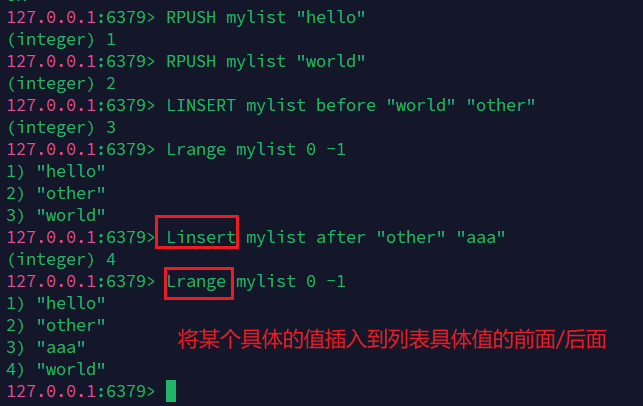
【总结】实际上是一个链表,左边和右边都可以插入。若key不存在,创建新的链表。若存在链表,则新增内容。若移除key,所有的value则消失。在两边插入或改动值,效率最高!中间元素,效率低一些。
消息排队:消息队列(LPUSH RPOP), 栈(LPUSH RPOP)
redis中的list是有序的元素集合,支持从两端推入元素、从两端弹出元素、按下标访问、截取部分列表。典型的【队列】【栈】功能,都可以基于list实现。
| 场景 | 底层结构 | 特点 |
| 元素数量少且元素小 | ziplist压缩列表 | 连续内存块,节省空间 |
| 元素多或元素大 | quicklist快速列表 | 多个ziplist组成的双向链表 |
(redis 3.2之前是ziplist和linkedlist,之后旧统一成quicklist了)
Set中的值不能重复。无序不重复集合。
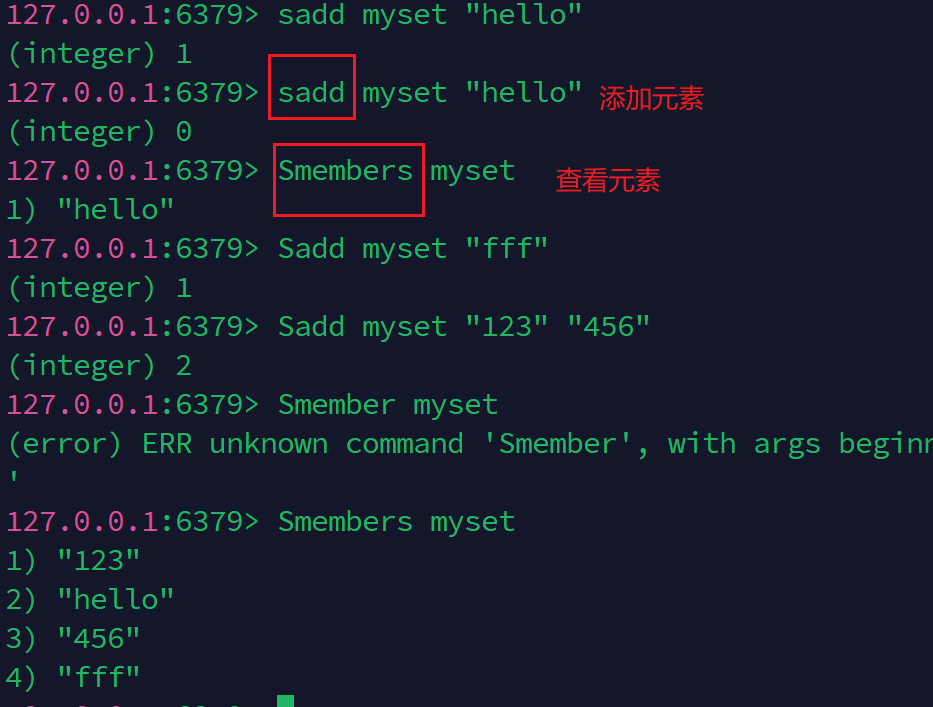
Sismember:查看某个元素是否在集合中。

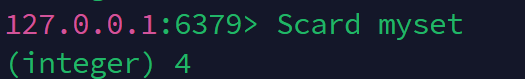
获取元素的个数:Scard myset
移除元素:Srem myset hello

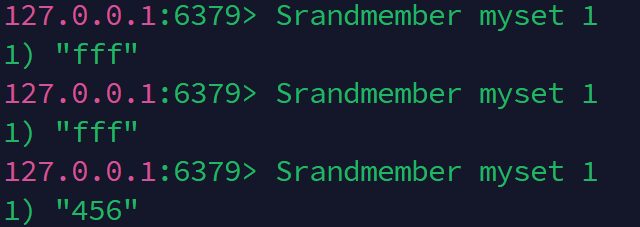
随机抽元素:Srandmember myset 1 # 随机抽取一个元素
删除指定的key,随机删除key:Spop myset # 随机删除
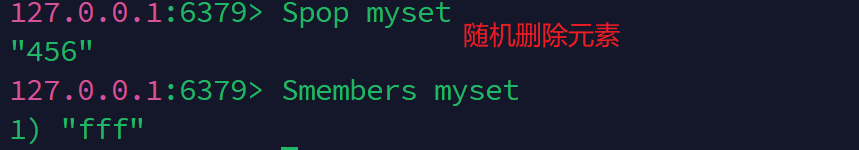
将一个指定的key移动到另外一个set集合中。

微博等共同关注(差集、交集、并集):
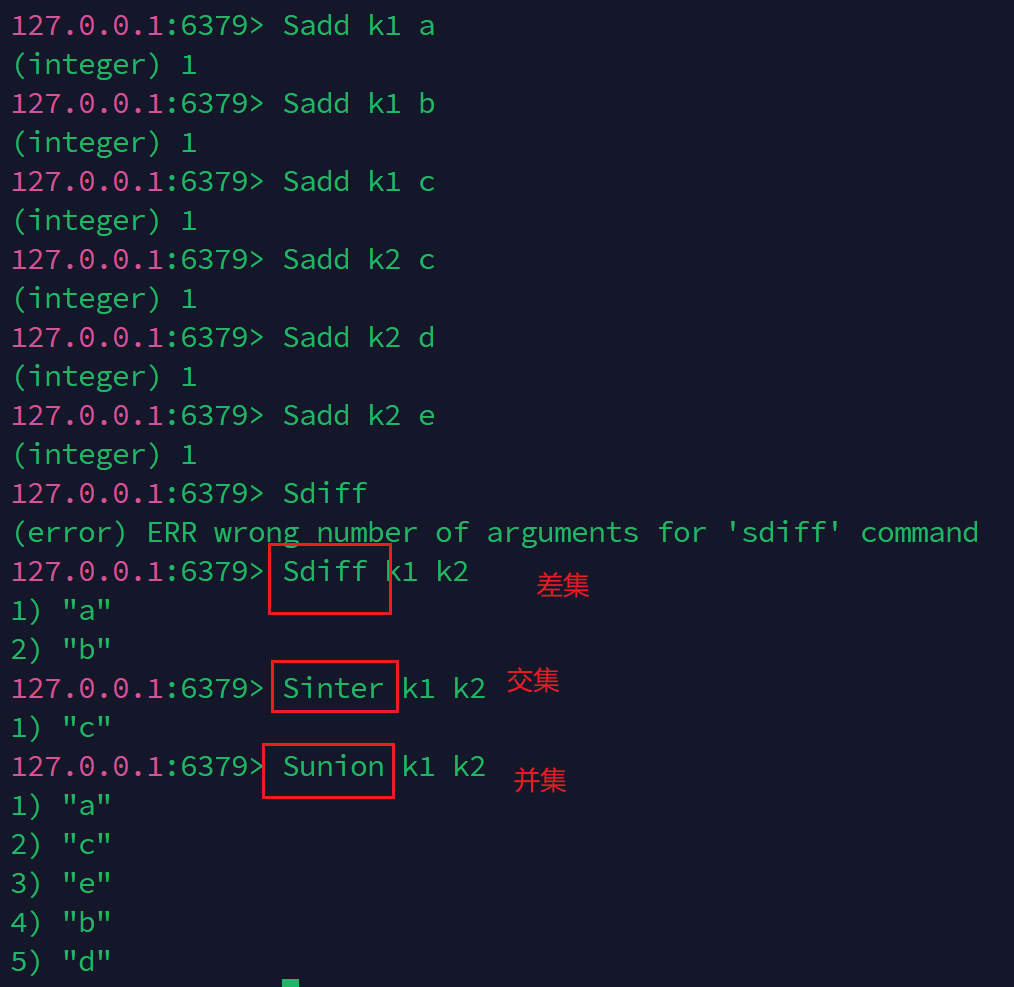
总结:A用户将所有关注的人放在一个集合中,粉丝也放在一个集合中,还可以求共同关注。
Set是一种不允许元素重复的无序集合,支持常见集合操作。查询、插入、删除元素时间复杂度是O(1)。
| 元素数量和大小 | 底层数据结构 | 特点 |
| 数量小,元素是整数 | intset(整数集合) | 节省内存,连续存储 |
| 元素多或包含非整数 | 哈希表 | 快速查找,支持任意字符串 |
【举个例子】假如在redis里执行:SADD myset 1; SADD myset 2; SADD myset 3. 全是整数,数量只有3个,远小于512(默认set-max-intset-entries)。若这样要使用传统哈希表(需要哈希桶数组,每个元素还要单独存一份key,甚至有指针开销),小量元素时dict的内存浪费很明显。而intset直接用连续的一块内存,存放整数,没有指针也没有额外哈希开销,纯粹存数据。所以这时候用intset更好,每个元素占用内存极小,且intset是连续数组,可以直接二分查找(但哈希就要做哈希元素、哈希冲突处理,流程更复杂)。
redis设计得很灵活,当intset元素数量超过阈值(默认512个),或者插入了非整数元素,就会自动升级成dict,保证兼容性,不需要人工干预。
【Set的扩容机制】当intset超过一定数量或插入非整数元素,会自动转成哈希表。dict元素太多时自动扩容rehash,保持低负载因子,提高性能。(负载因子 = 当前元素个数/哈希桶总数量)简单来说就是每个哈希桶平均有多少元素,若负载因子太高,冲突就多,查找、插入的性能就会下降。所以为了让哈希表保持查找接近O(1)的速度,redis 要动态扩容,让桶变多,保持低负载因子。
(1)触发扩容条件:当redis中的哈希表满足以下情况之一时就会触发扩容:元素个数>哈希表大小(负载因子>1); 若当前执行BGSAVE、AOF rewrite等持久化动作期间,为了避免内存膨胀,负载因子上限提高到5。-->一般情况下,元素数一旦超过桶数量,就触发扩容。
(2)redis扩容不是简单地扩大桶数组,而是 新建一个更大的哈希表(一般是原来的2倍大小),把老哈希表的元素一个个搬迁(rehash)到新表里。这个过程叫做rehash(再哈希)。
(3)渐进式搬迁:rehash不会一次性把所有元素伴奏,而是每次写操作时顺便搬迁一点。(这样做的目的是防止一次性阻塞redis,避免卡顿,适合高并发环境)
1. 用户标签管理
SADD user: 123:tags "sports" "reading" "coding"    # 给用户打兴趣标签
SMEMBER user: 123: tags      # 查询用户有哪些标签
2. 去重系统
SADD access:2025-04-28 192.168.1.1            # 统计每天独立IP访问
SADD access:2025-04-28 192.168.1.2

SCARD access:2025-04-28                    # 统计当天UV(独立用户数)
3. 好友关系/关注关系
SINTER user:123:following user:456:following # 一个用户关注了哪些人,交集求共同好友
1. 内存膨胀问题:当set中元素特别多时(比如几百万个用户),底层哈希表会不断扩容,占用大量内存。-->需要合理估计元素数量,可能时用HyperLogLog或bitmap来替代。
user:active:2025-04-28
user:active:2025-04-29
2. 集合运算消耗大:SUNION、SINTER、SDIFF在集合很大时,时间复杂度是O(N)-->可能导致redis阻塞,特别是超大集合千万级别。
3. 元素过大导致性能下降:若set中的元素本身很大,如超长字符串,哈希冲突变多,查询效率下降。
key-Map集合,这时候的值是一个map集合。
存一个值、取值; 多次存值取值;获取所有的值。
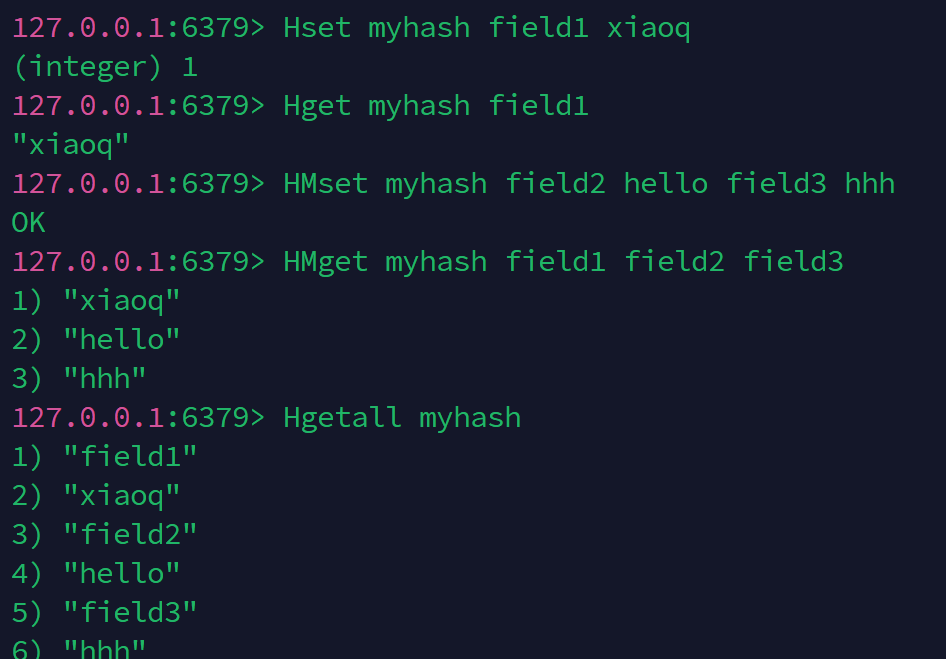
删除某个值:Hdel myhash field1
看这个key里面有多少个map:Hlen myhash
判断某个key对应的值的key的value是否存在:Hexists myhash field1
只获得所有的field、value:Hkeys myhash、Hvals myhash
自增自减:Hincrby myhash filed3 1、Hdecrby myhash filed3 1
存在则创建失败,不存在则创建:Hsetnx filed1 xiaoq(报错)
应用:hash变更的数据user name age,尤其是用户信息之类的,经常变动的信息。更适合于对象的存储,String更适合字符串存储。
| 场景 | 底层结构 | 特点 |
| filed数量少且filed和value都很小 | ziplist | 内存连续,节省空间 |
| filed数量多或某个filed/value很大 | 哈希表 | 查找快,支持大规模数据 |
【ziplist】单块连续内存,把field和value依次紧凑存放:[field1][value1][field2][value2]...
节省内存,但查找要顺序扫描O(N)。适合小数据量场景,比如几十个短字段的小对象。
【dict】标准哈希表实现(桶+连败哦/rehash),和普通redis dict一致。支持快速查找O(1),支持大对象(很多filed没货field/value很长)
【自动切换机制】field数量超过hash-max-ziplist-entries(默认512),或某个field/value长度超过 hash-max-ziplist-value(默认64字节)。只要任一条件满足,Hash会自动从ziplist升级成dict。
HINCRBY page:viewcount page1 1
HINCRBY page:viewcount page2 1
hash-max-ziplist-entries、hash-max-ziplist-value,适配自己业务场景。底层原理:元素唯一、每个元素关联一个浮点型分数的集合,按照分数大小有序排列。
Zset主要由两部分结构组成(双结构设计):
当元素数量很少而每个元素内容很小时,redis用ziplist(压缩列表)代替哈希表+跳表:
【举个例子】比如一个游戏需要实时显示【玩家积分排行榜】,每个玩家有一个唯一的playID,且有一个不断变化的积分score。要支持:1)查询积分最高的前100名;2)某个玩家当前排名;3)玩家积分增加或减少;4)按积分范围查询玩家(如找出在5000-6000之间的玩家)。问:如何用redis Zset实现?
【步骤一:存储玩家积分】
ZADD game:rankings 1500 player_001
ZADD game:rankings 2200 player_002
【步骤二:更新玩家积分】
ZINCRBY game:rankings 200 player_001 # 玩家1积分增加200分
【步骤三:查询积分最高的前100名】
ZREVRANGE game: rankings 0 99 WITHSCORES # 返回分数最高的100个玩家及其积分
【步骤四:查询某个玩家当前排名】
ZREVRANK game:rankings player_001 # 返回玩家1当前的名次(注意是0-based排名)
【步骤五:查找积分在某个区间的玩家】
ZRANGEBYSCORE game:rankings 5000 6000 WITHSCORES # 查找积分在2000-6000分之间的玩家
为什么用Zset适合这种场景?——首先Zset是按分数排序,跳表结构,查询高效;插入/更新快速;可以直接查询某个元素的分数;也可以按范围查找。
【注意事项】
Level 2: 1 -----> 5 -----> 9 -----> 13
Level 1: 1 -> 3 -> 5 -> 7 -> 9 -> 11 -> 13 -> 15
Level 2:  1 -------> 5 -----> 6 -----> 9
Level 1:  1 -> 3 -> 5 -> 6 -> 7 -> 9
3. reid跳表有没有保护机制?(比如随机分布出现问题,比如极端都很低)
#define ZSKIPLIST_MAXLEVEL 32 /* Should be enough for 2^32 elements */ 也就是说,不管怎么随机,最多只能出现32层索引,防止跳表层数异常高导致查询变慢或浪费内存。为什么设置32?理论上32层可以支撑接近2^32个元素(40亿个节点)而仍保持查询效率在O(logN)。大多实际应用中,元素数量远达不到40亿。
redis提供了一套基于地理坐标的DPI,可以存储经纬度信息,并支持:按城市名查经纬度、查询指定范围内的城市、计算两个点之间的距离。
GEOADD china 116.40 39.90 "Beijing"
GEOADD china 121.47 31.23 "Shanghai"
GEOADD china 113.26 23.13 "Guangzhou"

GEODIST china Beijing Shanghai km    # 计算距离
GEORADIUS china 116.40 39.90 1000 km WITHDIST  # 查询北京周围1000km内的城市
场景:附近商家、附近车主、外卖派单。
用于估算集合中不重复元素的数量(即去重后有多少个元素)。误差<1%,空间始终固定为~12KB。
PFADD uv_count user1
PFADD uv_count user2
PFADD uv_count user1        # 重复添加,不影响结果
PFCOUNT uv_count        # 返回大概有多少唯一用户(=2)
场景:网站UV统计(unique visitor)、活跃用户数、独立IP数量统计;日志去重计数。
位图在redis中其实是对字符串类型的一种位级操作扩展,本质上是一个二进制数组。每个位只能是0或1,位数可以很多,理论上512MB的字符串可支持2^32个bit。
SETBIT user_sign:20240509 1001 1        # 表示用户1001签到
SETBIT user_sign:20240509 1002 1
SETBIT user_sign:20240509 1003 0

GETBIT user_sign:20240509 1001  => 1
# 统计 key 中值为 1 的 bit 数(即有多少人“签到”了)
BITCOUNT user_sign:20240509  => 2
场景:用户签到、用户行为标记(是否点赞、是否浏览过)、活跃用户统计等。
上一篇:Java学习笔记-250427
下一篇:为什么不能用浮点型表示金额?
【从0到1构建一个ClaudeAgent】协作-Agent团队
 关注微信